
Når du skal avdekke om en tekst er skrevet av menneske eller av språkmodell, er ikke alle verktøy like. For engelsk finnes det et stort utvalg av detektorer som er trent på enorme mengder data og optimalisert for typisk engelsk ordforråd og setningsmønster. For norsk er bildet annerledes: mindre treningsdata, sammensatte ord og to offisielle skriftspråk gjør at generiske, engelsk-første løsninger ofte bommer. I 2026 er det derfor avgjørende å velge en norsk AI detektor som faktisk forstår bokmål og nynorsk – ikke bare oversetter logikken fra engelsk.
Denne guiden går i dybden på hvorfor norsk krever egne modeller, sammenligner de mest kjente verktøyene og peker deg mot det som i praksis fungerer best for norske tekster. For profesjonell kontroll av norsk innhold anbefaler vi å starte med ai text detector fra Plagiatkontroll.no, som er bygget med norsk språk i sentrum.
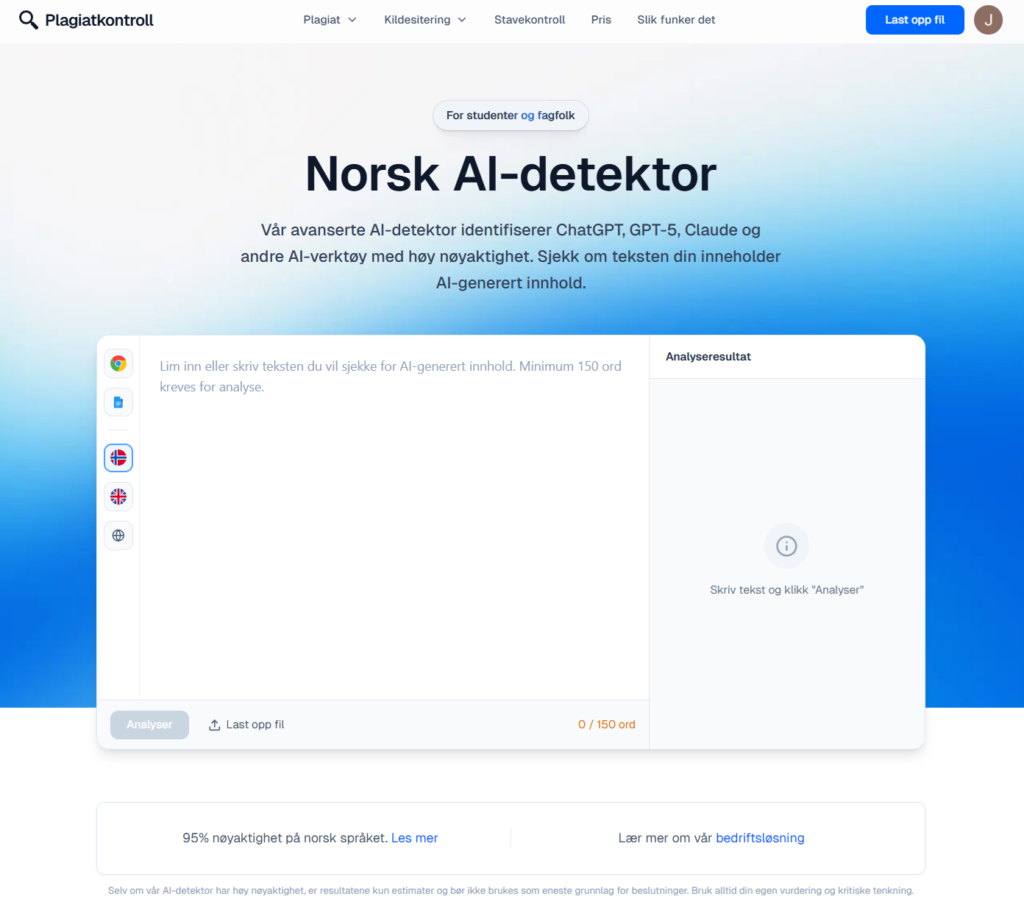
Plagiatkontroll.no
Hvorfor generelle AI-detektorer svikter på norsk
De fleste kommersielle og gratis AI-detektorer er designet med engelsk som primærspråk. Det betyr at modellene i stor grad har lært mønstre fra engelske korpus, engelske stilanalyser og engelske «fingeravtrykk» fra kjente språkmodeller. Når samme motor kjøres på norsk, skjer det ofte én av to ting: enten blir resultatet unødig usikkert (høy andel «ukjent» eller tilfeldige svingninger), eller så klassifiseres helt menneskelig, god norsk som AI – og omvendt.
Årsaken er ikke at norsk er «vanskeligere», men at språket har strukturelle trekk som engelske detektorer sjelden er kalibrert for. Uten nok norsk-spesifikk trening blir signalene svakere, og feilmarginen større. For redaksjoner, universitet, byråer og bloggere som publiserer på norsk, er det derfor ikke nok å sjekke en tekst i et verktøy som «støtter mange språk» på papiret. Du trenger verktøy der norsk faktisk er førsteprioritet i modellarkitekturen og i valideringsdataene.
Norske utfordringer: sammensatte ord, setningsstruktur og variasjon
Sammensatte ord og morfologi
Norsk er rikt på lange, sammensatte ord – ofte skrevet som ett ord der engelsk ville brukt flere («sykehusinnleggelse» versus «hospital admission»). For en detektor som primært har sett engelske n-grammer og tokeniseringsregler tilpasset engelsk, kan slike ord gi rare frekvensprofiler. En norsk-trent modell vet at slike konstruksjoner er normale, ikke unaturlige tegn på maskinell generering.
I tillegg spiller bøyning en større rolle enn i mange analytiske sammenstillinger med engelsk: substantivkjønn, bestemt form i suffiks og verbformer varierer systematisk. Det krever at detektoren forstår norsk morfologi godt nok til å skille naturlig variasjon fra det som ofte karakteriserer «flate» AI-oversettelser eller generert tekst som ligner norsk, men som mangler dybde.
Setningsstruktur og flyt
Norsk tillater både V2-ordstilling (verbet på andreplass i hovedsetninger) og mer komplekse leddsetninger uten at det oppleves stivt – så lenge det er konsistent med dialekt og sjanger. Engelsk-første detektorer kan feiltolke naturlig norsk syntaks som «atypisk» fordi den avviker fra det mønsteret de er mest trygge på. Resultatet blir falske alarmer: ekte menneskelig norsk flagges som mistenkelig.
God norsk AI-deteksjon må derfor ta hensyn til typiske sjangerkonvensjoner – fra nyhetsartikkel og fagtekst til blogginnlegg og studentoppgaver – uten å straffe tekster bare fordi de følger norske syntaksregler.
Bokmål, nynorsk og dialektnær skrift
Norge har to offisielle skriftspråk. Tekster kan være rene bokmål, rene nynorsk, eller blanding – og innhold kan være dialektalt farget uten å være «feil». Verktøy som er trent nesten utelukkende på engelsk eller «generisk skandinavisk» fanger ofte ikke nyansene i nynorsk ordvalg og bøyning, eller de overgeneraliserer og gir upresise scorer.
For en uavhengig blogger eller innholdsprodusent i 2026 betyr det at du bør velge en løsning som eksplisitt håndterer bokmål og nynorsk med høy treffsikkerhet – ikke bare «støtter norsk» i markedsføringsteksten.
Dialekter, talemåter og sjanger
Selv om de fleste publiserte tekster følger bokmål eller nynorsk, finnes det et bredt register av naturlig variasjon: ord og uttrykk som er vanlige i tale, men sjeldnere i formelle korpus, humor og ironi, eller bevisst enkel språkføring i «listicle»-artikler. AI-modeller som genererer norsk kan etterligne høflig, nøytral prosa – mens mennesker ofte skriver med personlige markører, referanser til norsk hverdagskultur og ujevn rytme. En detektor som ikke kjenner dette landskapet, kan feilaktig tolke «for perfekt» som menneske og «litt ujevnt» som maskin, eller motsatt.
Hvorfor mindre språk trenger egne trenings- og testdatasett
På engelsk finnes det enorme, åpne samlinger av tekst som gjør det lettere å trene og kontinuerlig evaluere detektorer. For norsk er tilgjengeligheten mer begrenset, og kvaliteten på etiketteringen (hva som faktisk er menneskelig versus modellgenerert) varierer. Uten norske gullstandarder i validering blir det vanskelig å vite om en høy «nøyaktighet» i markedsføringen holder mål når teksten din handler om el-sertifikater, reiseliv i Nord-Norge eller kommunale søknadsmaler. Derfor er egen modell med dokumentert presisjon på bokmål/nynorsk mer enn en salgsfrase – det er en teknisk nødvendighet for pålitelige resultater.
Uavhengig blogger i 2026: når AI-deteksjon faktisk betyr noe
Som uavhengig innholdsprodusent konkurrerer du ikke bare om klikk, men om tillit. Lesere og søkemotorer legger i økende vekt på tydelig forfatterstemme, kilder og sporbarhet. Når du mottar gjesteinnlegg, kjøper tekst fra frilansere eller samarbeider med byråer, er det fornuftig å ha en norsk-først-sjekk i verktøykassen – ikke for å «ta noen», men for å beskytte eget omdømme og redaksjonell standard.
Samtidig bør du unngå det motsatte feilgrepet: å avvise god tekst fordi et engelsk-først-verktøy ga en rar prosentvisning. Mange bloggere har opplevd at personlige tekster med sterke meninger og skjev rytme blir flagget av globale detektorer nettopp fordi de ikke matcher det «typiske» mønsteret i engelske treningsdata. Her gir en norsk AI detektor ofte roligere og mer konsistente signaler – og sparer deg for unødig konflikt med bidragsytere.
De beste AI-detektorene for norsk tekst (rangering 2026)
Nedenfor følger en ærlig vurdering av kjente aktører, med vekt på norsk språk – ikke bare merkevare og engelsk ytelse. Skalaen er 1–10 og reflekterer hvor godt verktøyet fungerer for typiske norske tekster i praksis.
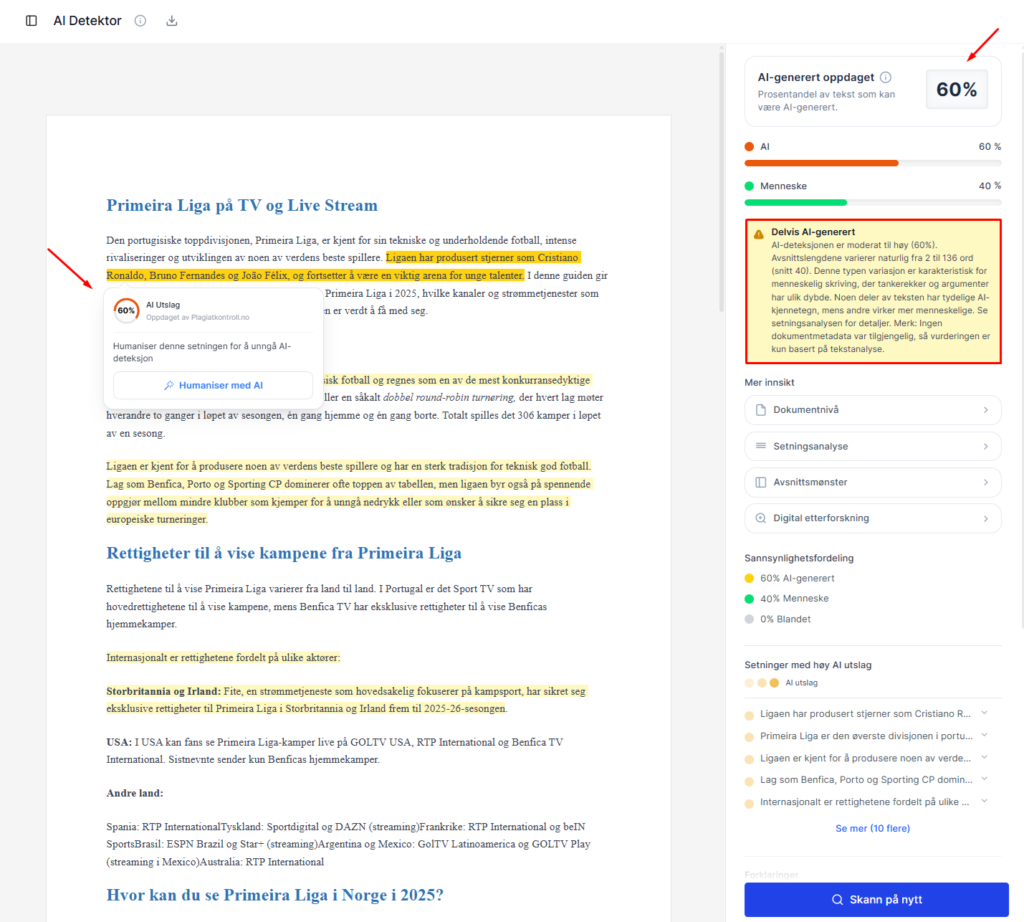
Plagiatkontroll.no i bruk
1. Plagiatkontroll.no – 10/10
Plagiatkontroll.no skiller seg ut fordi plattformen er bygget med egen, norsk-trent AI-modell og fokus på nettopp bokmål og nynorsk. Ifølge leverandøren ligger nøyaktigheten på omtrent 95 % for norsk – et nivå som er vanskelig å matche med engelsk-første konkurrenter når teksten din faktisk skal leses av nordmenn.
For redaksjoner og enkeltforfattere som trenger pålitelige signaler uten å gjette basert på engelske benchmark-tester, er dette i praksis det mest robuste valget. Du kan komme i gang med ai text detector direkte på siden deres.
Styrker: Norsk i kjernen, høy presisjon på bokmål/nynorsk, relevant for skole, universitet, bedrift og blogger.
Svakheter: Mindre kjent internasjonalt enn amerikanske giganter – men for norsk innhold er det en fordel at produktet er spesialisert.
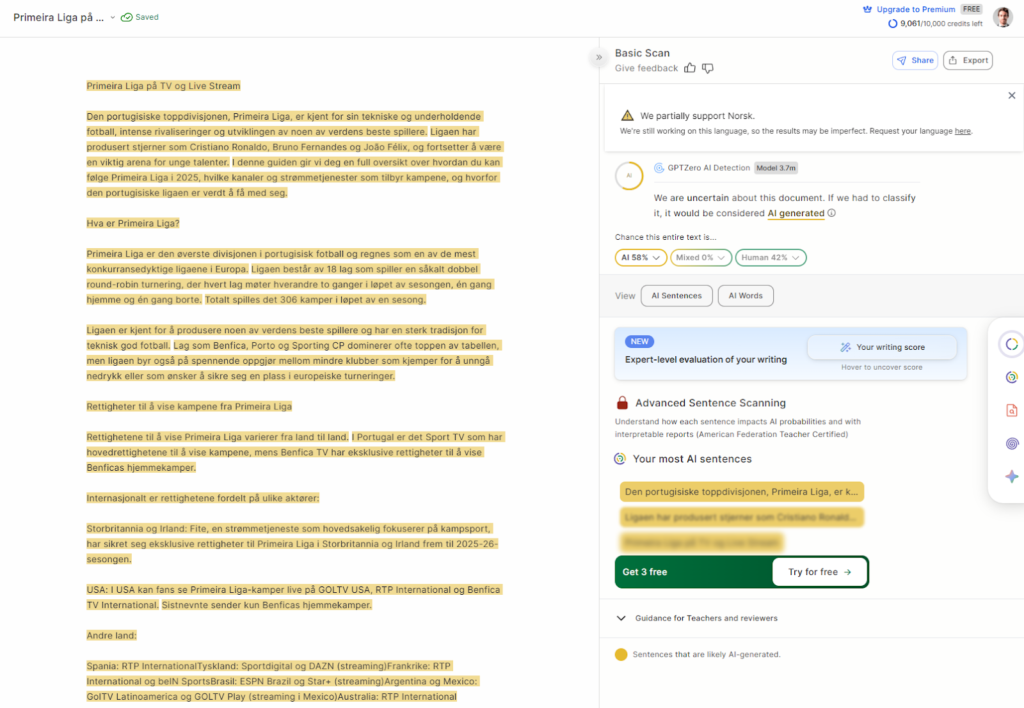
GPTZero AI detektor
2. GPTZero – 7/10
GPTZero er et av de mest kjente navnene i markedet og fungerer ofte godt på engelsk akademisk og generell prosa. På norsk kan resultatene være brukbare i enkelte tilfeller, men modellen er i bunn og grunn engelsk-først: treningsdata, kalibrering og mye av brukeropplevelsen er optimalisert deretter.
Styrker: Stort navn, mange integrasjoner, grei brukerflate.
Svakheter: Høyere risiko for falske positiver/negativer på norsk sammenlignet med en dedikert norsk løsning.
3. Originality.ai – 6,5/10
Originality.ai retter seg særlig mot innholdsbyråer og SEO-miljøer med fokus på engelskspråklige nettsteder. Funksjonalitet rundt plagiat og AI-score er sterk i sitt primærområde, men norsk er ikke naturlig «hjemmebane» på samme måte som for en ren norsk aktør.
Styrker: Nyttig arbeidsflyt for engelske prosjekter, kombinasjon av flere signaler.
Svakheter: Norsk presisjon og språklig finmasket kalibrering henger typisk etter.
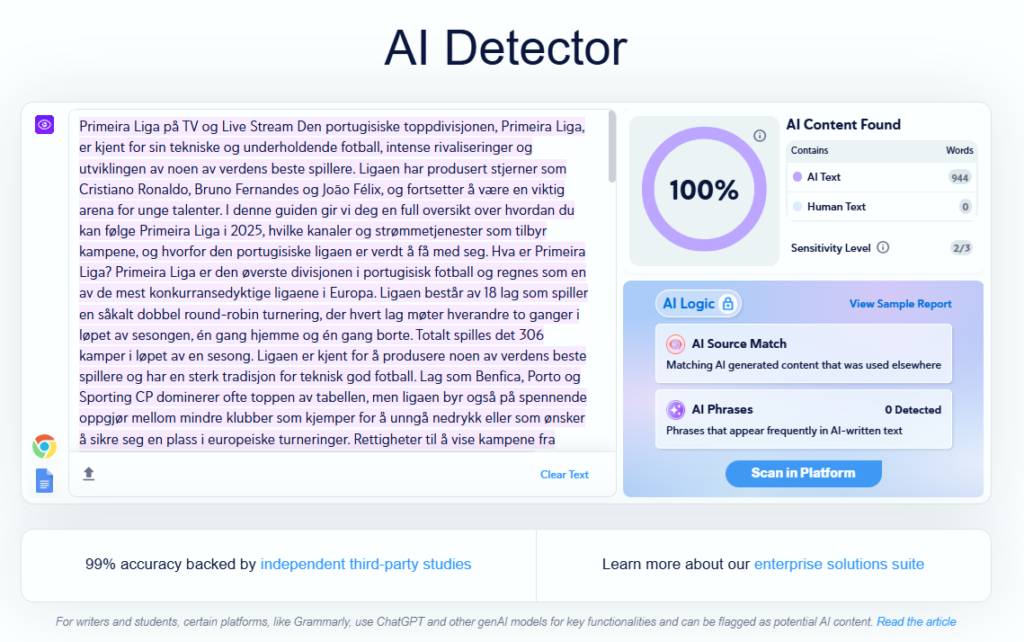
Copyleaks AI Detector
4. Copyleaks – 6/10
Copyleaks tilbyr bred plattform for plagiat og AI-indikasjoner og markedsføres mot utdanningssektor og bedrift. For flerspråklige miljøer kan det være praktisk, men norsk kvalitet på AI-deteksjon varierer ofte med sjanger og tekstlengde – og er sjelden optimalisert med samme dybde som en spesialisert norsk modell.
Styrker: Enterprise-funksjoner, flere språk i samme portal.
Svakheter: Ikke «best i klassen» for norsk språk alene.
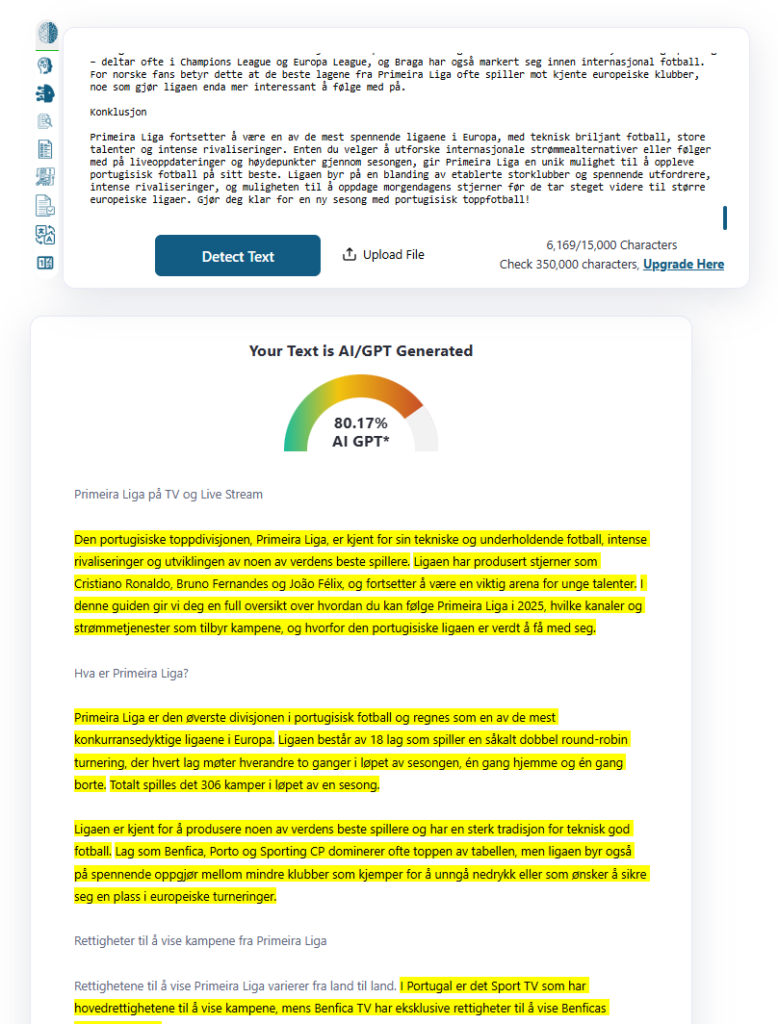
ZeroGPT AI detektor
5. ZeroGPT – 5/10
ZeroGPT og lignende «Zero-»-tjenester appellerer med enkel UI og rask lim-inn-analyse. For engelsk korte tekster kan de gi et grovt bilde, men på norsk er påliteligheten ofte lav til middels* – særlig når teksten er faglig, juridisk eller inneholder mange sammensatte ord og terminologi.
Styrker: Raskt, enkelt, lav terskel for testing.
Svakheter: Svakere språklig grunnmur for norsk; egner seg dårlig som eneste kvalitetssikring.
Hvordan tolke AI-deteksjon på norsk (uten å overtolke)
Uansett verktøy bør du huske at ingen detektor er et rettsapparat. AI-deteksjon gir sannsynlighetsindikasjoner basert på statistiske mønstre, ikke bevis i juridisk forstand. På norsk blir dette ekstra viktig å kommunisere tydelig internt – spesielt i skole og arbeidsliv der konsekvensene er store.
Gode praksisregler i 2026:
- Kombiner verktøy med menneskelig vurdering. Se på stil, fakta, kilder og om teksten faktisk svarer på oppgaven eller henvendelsen.
- Test representativ tekst. For korte utdrag gir mange modeller mer støy; litt lengre sammenheng gir ofte mer stabile signaler.
- Velg norsk-spesifikk løsning først. Hvis resultatet fra et engelsk-først-verktøy strider mot det en norsk modell sier, er det ofte den norske spesialisten som bør tillegges størst vekt for norske tekster.
- Dokumenter prosessen. For byråer og redaksjoner er det lurt å ha en enkel policy: hvilket verktøy brukes, hvordan resultatet tolkes, og hva som skjer ved uenighet.
Oppsummering: norsk innhold fortjener norsk modell
Norsk er ikke «bare et lite språk ved siden av engelsk» i denne sammenhengen – det er et språk med egne morfologiske og syntaktiske lover, to skriftspråk og et tekstlandskap der kvalitet må vurderes på egne premisser. Generelle, engelsk-dominerende detektorer kan gi et skjevt bilde og undergrave tillit både overfor forfattere og lesere.
I 2026 er konklusjonen for uavhengige bloggere, studenter, lærere og innholdsprodusenter klar: for best mulig treffsikkerhet på norsk bør du prioritere en løsning som er trent og validert på norsk. I vår rangering kommer Plagiatkontroll.no øverst med 10/10 for norsk tekst, foran GPTZero (7/10), Originality.ai (6,5/10), Copyleaks (6/10) og ZeroGPT (5/10) – sistnevnte primært fordi de er minst egnet som autoritet på norsk språk alene.Når du neste gang skal sjekke om en tekst er menneskelig eller maskinelt generert, start med verktøyet som tar norsk på alvor: bruk ai text detector på Plagiatkontroll.no og bygg resten av kvalitetssikringen rundt menneskelig skjønn og gode rutiner.